Я дал своему портфолио MCP-сервер
Почему и как я построил MCP-сервер поверх своего личного сайта — чтобы AI-ассистенты могли напрямую запрашивать мои проекты, опыт и техническую работу.
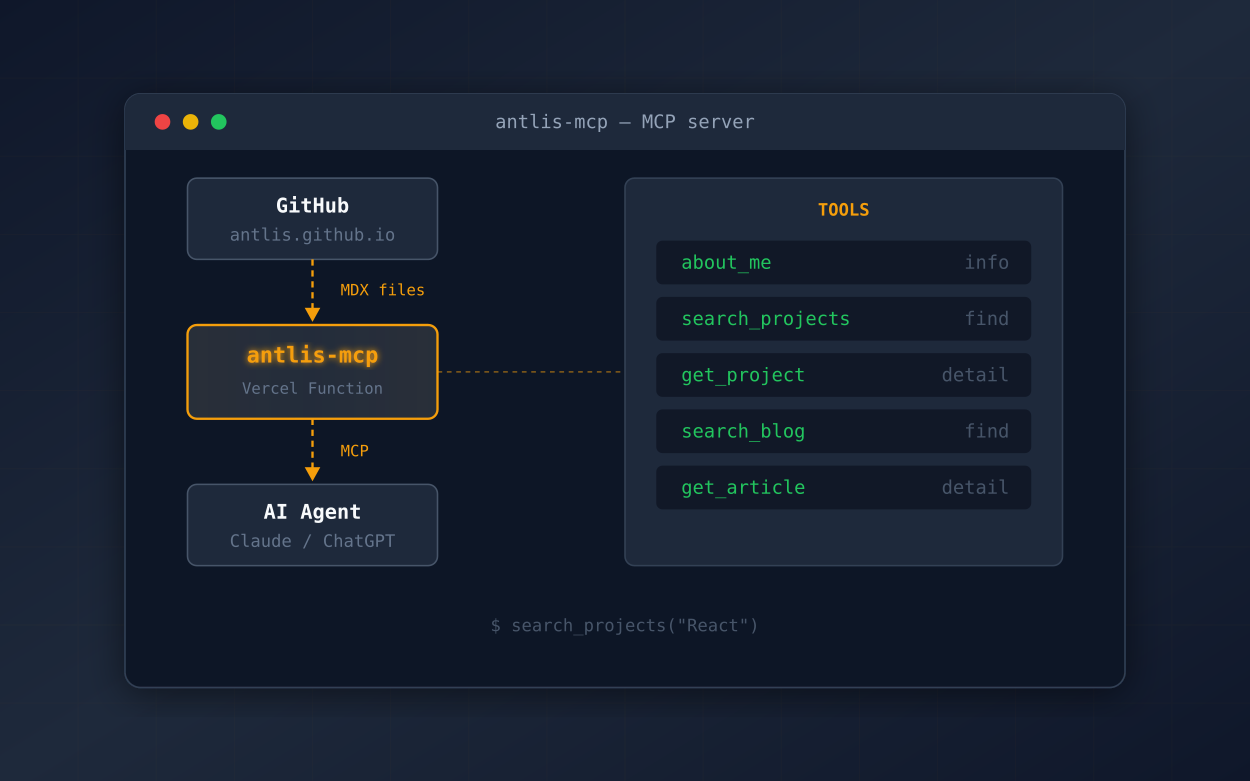
Я стал чаще экспериментировать с AI-агентами и MCP, и в какой-то момент у меня возникла простая мысль:
А что если дать моему личному сайту MCP-сервер?
Я не решаю здесь какую-то огромную проблему. Мой сайт не такой уж большой, у меня нет тысяч статей или масштабной базы знаний, которой отчаянно нужен AI-поиск.
Мне просто показалось, что это будет интересно собирать.
А поскольку у меня уже был сайт с проектами, статьями и прочим контентом — это казалось хорошим местом для экспериментов с MCP.
Суть идеи
Сайт — это Astro-проект, и бо́льшая часть контента хранится как Markdown/MDX в Git-репозитории.
Я хотел сохранить это как источник правды и построить поверх небольшой MCP-сервер.
Основная идея:
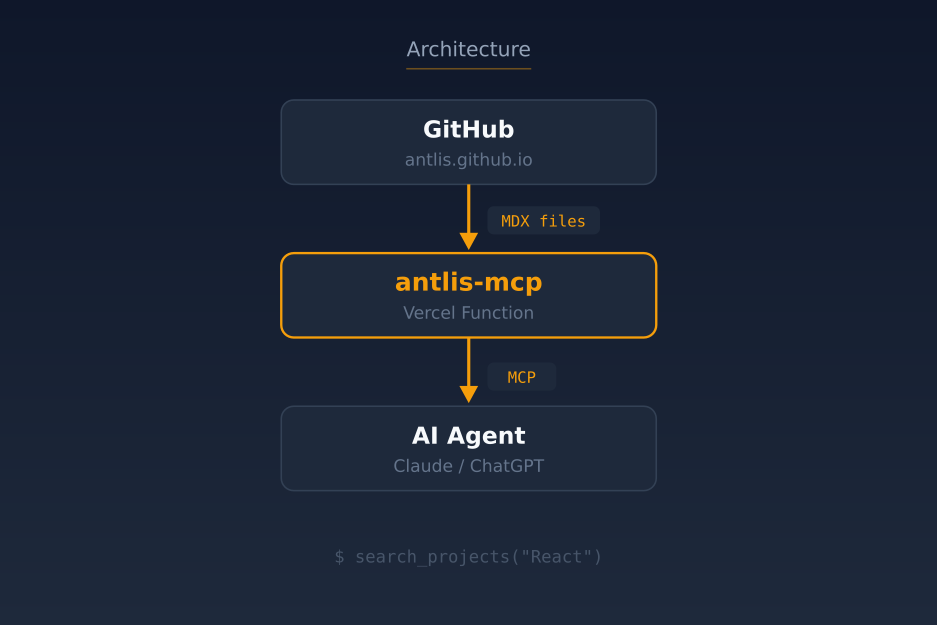
Ничего особенно сложного.
MCP-сервер читает контент из репозитория и предоставляет AI-клиентам полезные операции.
Инструменты
Я начал с пяти инструментов:
about_mesearch_projectsget_projectsearch_blogget_articleПоиск проектов находит по технологиям, темам, описаниям и другой информации о проектах.
Поиск по блогу работает аналогично, а get_project и get_article возвращают полные данные по конкретному элементу.
Например, AI-агент может вызвать:
search_projects("React")и получить структурированную информацию о проектах.
Или:
get_article("ai-harness-setup")чтобы получить всю статью целиком.
Это, по сути, вся первая версия.
Почему GitHub?
Потому что контент уже там живёт.
Я не хотел вводить базу данных только ради этого проекта и не хотел поддерживать вторую копию контента сайта где-то ещё.
В репозитории уже есть Markdown/MDX-файлы, и MCP-сервер может их просто читать.
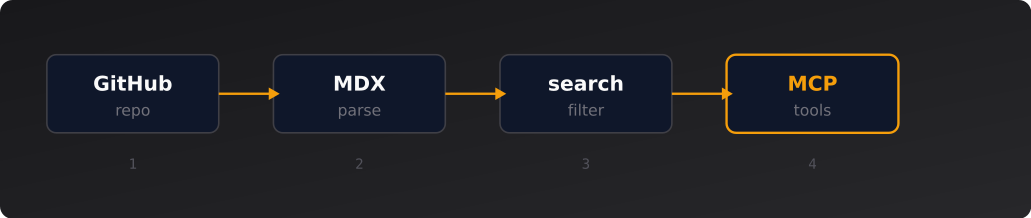
Для проектов я получаю дерево репозитория, нахожу MDX-файлы проектов, паршу их frontmatter и выдаю полезные поля.
Блог работает так же.
Это ещё и значит, что обновление сайта автоматически обновляет информацию, доступную через MCP, как только сервер подхватывает новые данные из репозитория.
Простота
Поскольку это в основном эксперимент, я намеренно избегал нагромождения AI-инфраструктуры.
Никакой векторной базы.
Никаких эмбеддингов.
Никакого RAG-пайплайна.
Никакого LLM внутри MCP-сервера.
Объём контента достаточно мал, чтобы обычный поиск прекрасно справлялся.
Реализация по сути:
Можно всегда сделать сложнее, если реально появится необходимость.
Пока что мне больше нравится небольшой проект, который легко понять.
Деплой на Vercel
Я задеплоил MCP-сервер как Vercel-функцию.
Эндпоинт:
https://antlis-mcp.vercel.app/api/mcpСервер написан на TypeScript и использует экосистему MCP SDK вместе с mcp-handler.
Репозиторий тоже подключен к Vercel, поэтому процесс деплоя теперь выглядит так:
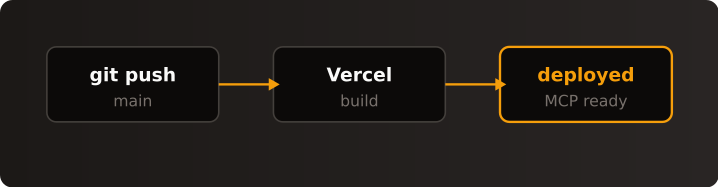
Приятно и скучно.
Подключение к Telegram AI-боту
Следующее, что я хотел попробовать — подключить MCP-сервер к AI-агенту, которым я уже пользуюсь.
У меня есть Telegram AI-бот на Hermes, и Hermes поддерживает MCP-серверы.
Я добавил удалённый MCP-эндпоинт к боту.
Архитектура теперь выглядит так:
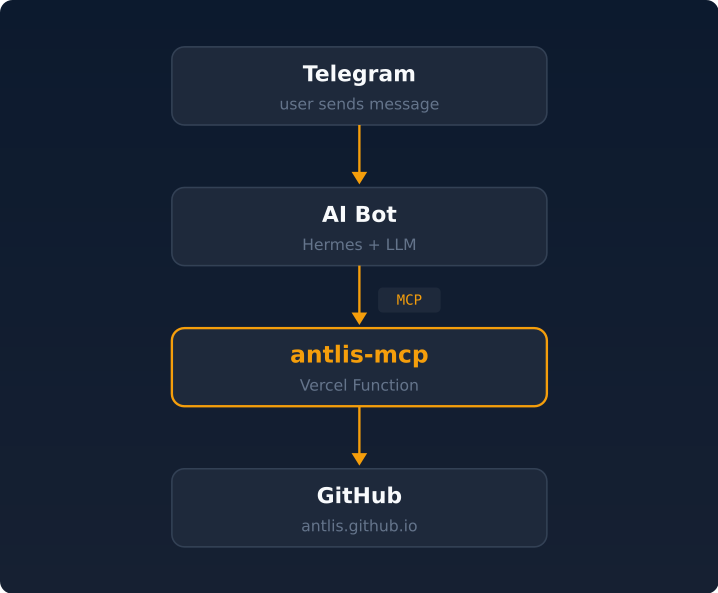
После подключения бот обнаружил все пять инструментов.
Это уже было хорошим подтверждением того, что сервер работает как надо.
Но, очевидно, просто видеть инструменты — не так уж интересно.
Я хотел, чтобы бот реально их использовал.
Первый реальный тест
Я спросил бота:
Какие проекты демонстрируют опыт с React?
Агент решил, что ему нужна информация с моего сайта, и вызвал MCP-инструмент поиска с запросом React.
MCP-сервер нашёл проекты и вернул подходящий.
Бот использовал результат, чтобы сформировать ответ.
Реальный флоу:
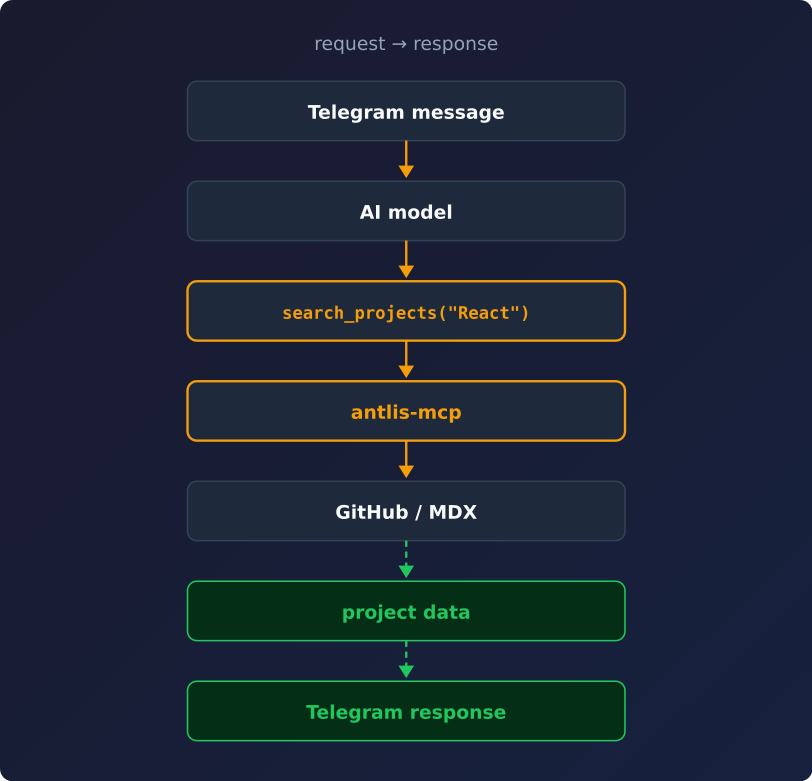
Вот это мне и было интересно.
Я не говорил боту явно, как искать информацию.
Он сам обнаружил, что у него есть инструмент, и решил его использовать.
Более сложный тест
Потом я спросил:
Какие проекты были бы самыми сильными для позиции Senior React/Next.js? Объясни рассуждения и используй данные портфолио, а не свои предыдущие знания.
Снова запрос к MCP-серверу, снова получение данных о проектах.
Ответ был разумным, но тест также выявил нечто важное при построении подобных систем.
Модель начала делать предположения, которых на самом деле нет в моих исходных данных.
Например, она вывела некоторые архитектурные детали из того факта, что проект использует Next.js.
Это хорошее напоминание о том, что MCP магически не предотвращает галлюцинации.
MCP-сервер может предоставить точную информацию, но модель всё равно может слишком агрессивно интерпретировать эти данные.
Думаю, хороший принцип проектирования здесь:
MCP → факты и доказательства
LLM → интерпретация и объяснение
Если в данных проекта сказано, что использовался React и Next.js, MCP-сервер должен вернуть ровно это.
Он не должен превращать это в утверждение о SSR, SSG, управлении состоянием или какой-то другой архитектуре, если этой информации фактически нет.
Модель сама может сделать вывод, но должно быть понятно, когда она делает предположение.
Что дальше
Есть несколько направлений, которые я хочу попробовать.
Очевидное — инструмент более высокого уровня:
recommend_for_roleВместо простого поиска React-проектов я могу попросить MCP-сервер найти проекты, релевантные:
Senior React / Next.js DeveloperСервер мог бы ранжировать проекты на основе их метаданных и возвращать обоснование каждого совпадения.
Также хочется поэкспериментировать с MCP-ресурсами и промптами.
Например, ресурсы могли бы выглядеть так:
portfolio://projects/topforexportfolio://projects/tg-mpv-botportfolio://articles/ai-harness-setupА промпты — предоставить переиспользуемые рабочие процессы по подбору вакансий или подготовке к собеседованиям.
Но я не хочу превращать это в большой проект только ради добавления фич.
Маленькая версия уже достаточно полезна как эксперимент.
Почему я это сделал
Честно говоря, основная причина в том, что MCP — это интересно.
Я часто использую AI-агентов и экспериментирую с разными способами дать им доступ к информации и инструментам.
Построить MCP-сервер для того, что у тебя уже есть — казалось гораздо лучшим способом изучить это, чем делать очередную игрушку.
Вместо:
"Hello world" MCP-серверу меня есть нечто, что реально подключено к моим данным.
И теперь один и тот же контент может иметь два совершенно разных интерфейса:
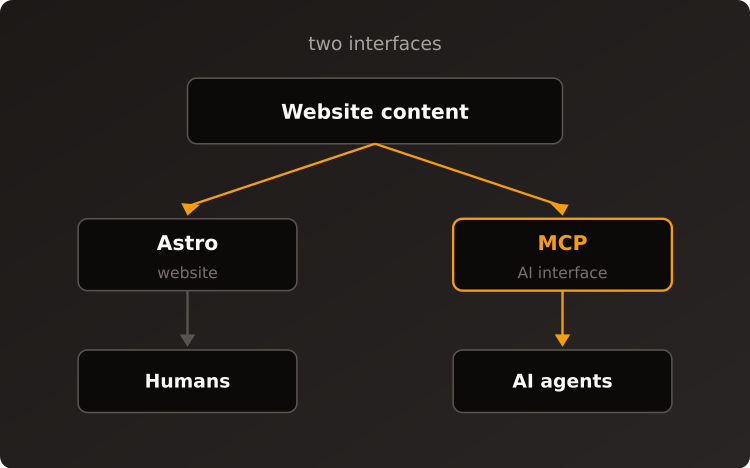
Сайту не нужно знать ничего об AI-агенте.
AI-агенту не нужно знать, как реализован сайт.
MCP-сервер стоит между ними и предоставляет те части, которые агенту имеет смысл использовать.
Это довольно элегантный паттерн.
Текущее состояние
Реализация намеренно маленькая:
antlis-mcp│├── about_me├── search_projects├── get_project├── search_blog└── get_articleОна развёрнута на Vercel, работает из того же Git-репозитория, что и сайт, и я успешно подключил её к своему Telegram AI-боту.
Исходный код доступен на GitHub: antlis/antlis-mcp
Теперь я могу спросить бота о своих проектах, и вместо того чтобы полагаться только на уже имеющийся контекст, он может обратиться к реальному источнику.
Попробуйте сами
Вместо того чтобы просто объяснять, что делает MCP, я встроил сюда небольшой клиент для него. Спросите что-нибудь о сайте.
Виджет отправляет ваш вопрос в LLM, который решает, какие MCP-инструменты вызвать, получает данные с сервера и отвечает на основе найденной информации. Можно развернуть карточки вызовов инструментов, чтобы увидеть, что именно было запрошено и что вернулось.
Позже я расписал, как этот виджет устроен от начала до конца — фронтенд, подключение к OpenRouter и как заставить его стримить ответ, как ChatGPT: Как я заставил чат-виджет портфолио стримить, как ChatGPT.
Текущее состояние
Пока этого достаточно.
Скорее всего, буду расширять по мере того, как будут появляться интересные идеи для MCP.
В этом и есть суть проекта — я хотел узнать, как работает MCP, дав чему-то, что у меня уже есть, AI-интерфейс.
Оказалось, что это довольно весело.